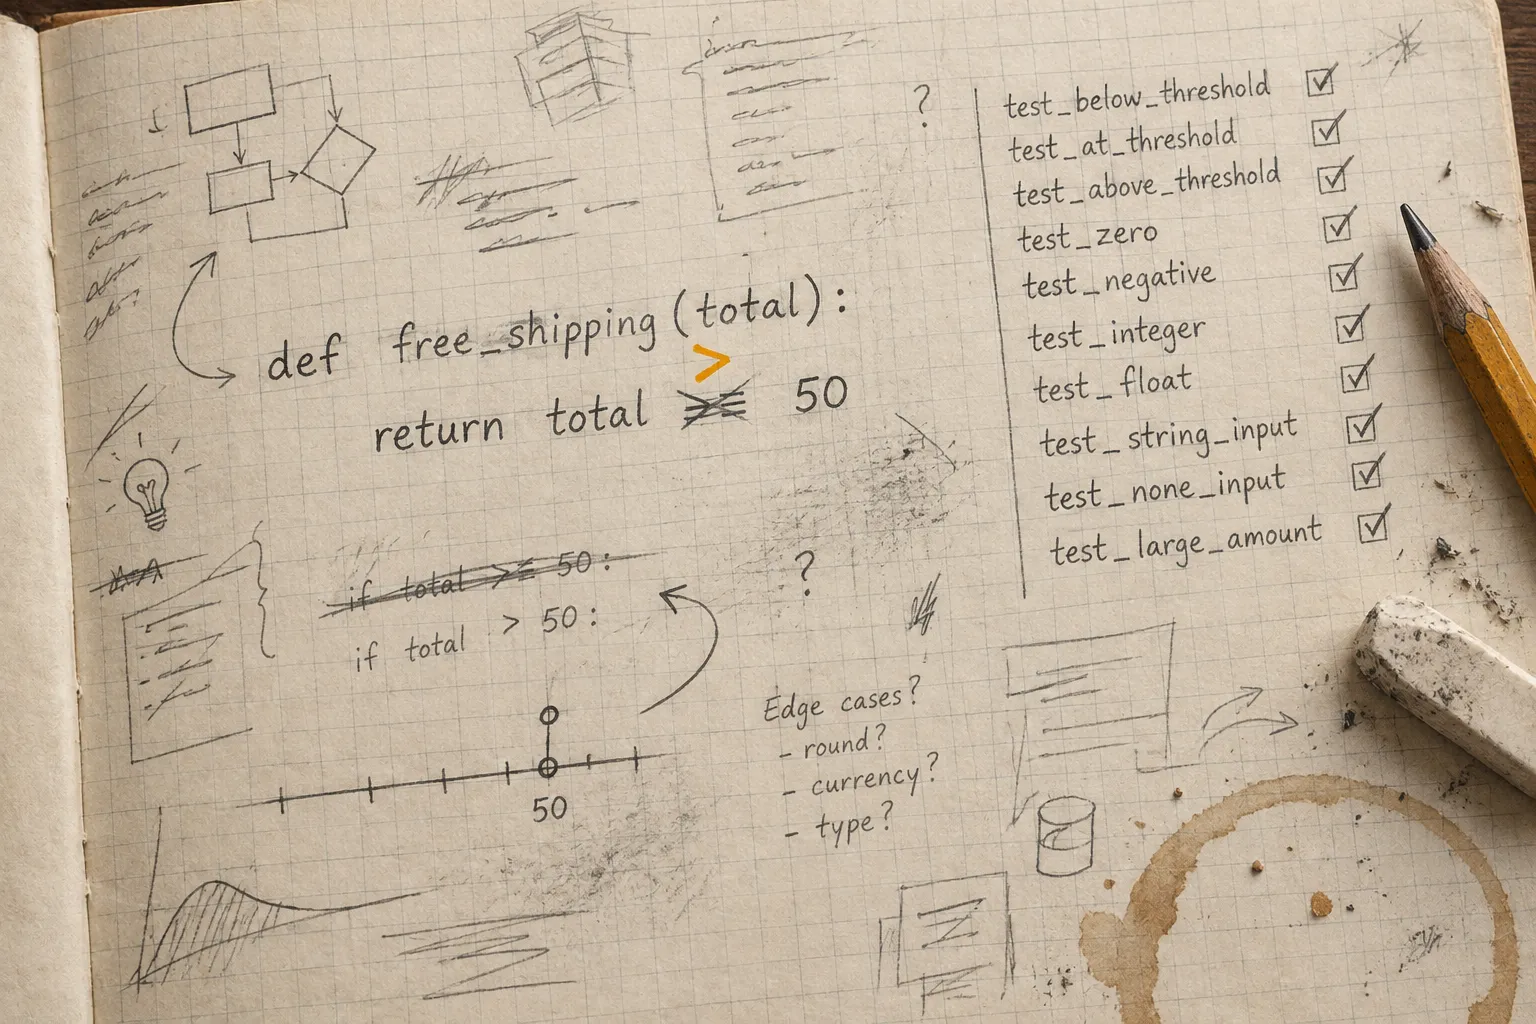
Prendi questa funzione.
def free_shipping(total: float) -> bool: return total >= 50
Chiedi a un agente di scriverci i test. Ne scrive parecchi, tutti verdi, copertura al 100%.
Poi lanci il mutation testing: lo strumento sostituisce >= con
> e rilancia la suite. I test passano ancora. Il mutante è sopravvissuto,
perché nessuno verifica cosa succede esattamente a 50.
L'agente se ne accorge e aggiunge assert free_shipping(50) is True. Il mutante
muore, il punteggio sale, e te ne vai a letto soddisfatto.
Ma chi ha detto che a 50 euro la spedizione debba essere gratuita? Il requisito dice "spedizione gratuita con soglia a 50 euro". Il 50 è incluso o escluso? Il testo non lo dice. Scrivendo il codice l'agente lo ha incluso, e ora lo include anche nel test: è l'unica scelta che fa passare la suite. Se la lettura giusta era l'altra, il test appena aggiunto ha "messo al sicuro" l'errore.
I test difendono anche il codice sbagliato
Il mutation testing risponde a una domanda precisa: se cambio il comportamento del codice, i test se ne accorgono? È una domanda utile, a cui la copertura da sola non sa rispondere. Una riga può essere eseguita da un test senza che nessuna asserzione dipenda da quello che fa. Per questo il mutation score sembra la metrica che mancava: misura i test invece di contarli.
Ma anche questa misura ha un presupposto: che il comportamento attuale sia quello giusto. Il mutation testing parte dal codice com'è e misura quanto i test lo difendono. Se il codice è sbagliato, difende lo sbaglio con la stessa efficienza.
Se chi scrive il test parte dal requisito e non dall'implementazione, una lettura diversa può saltare fuori. Quando implementazione, test e correzioni li produce lo stesso agente, nello stesso contesto, la lettura è una sola. Non tutti i sopravvissuti indicano un requisito ambiguo: molti segnalano solo test incompleti. Alcuni però cadono dove il requisito tace, e lì l'agente, per ucciderli, sceglie la lettura che ha già messo nel codice.
L'agente chiude il ciclo senza chiedere
Prima dei coding agent questo problema c'era, ma si vedeva poco. Il mutation testing trovava le debolezze, e sistemarle richiedeva tempo di una persona: guardare ogni mutante sopravvissuto, capire cosa mancava, scrivere il test, rilanciare. Su una suite grande il conto non tornava, e spesso lo si faceva su un modulo solo, una volta. Chi guardava un mutante a mano, di solito, finiva indirettamente per chiedersi cosa dovesse fare il codice in quel punto.
Con un agente il ciclo si chiude quasi da solo. Genera i test, esegue le mutazioni, legge i sopravvissuti, scrive i test che mancano, ricomincia, e la domanda non la fa più nessuno. Un agente a cui chiedi di portare il mutation score al 95% ci riesce, perché è un obiettivo che si può inseguire senza capire il dominio: basta guardare il mutante e scrivere il test che lo uccide.
Immaginiamo questo scenario. Un ordine passa da "in preparazione" a "spedito" a "consegnato". Il requisito elenca le transizioni previste e non dice niente sulle altre.
L'agente implementa una tabella delle transizioni ammesse; tutto il resto solleva un errore. Il mutation testing toglie il controllo, e un ordine spedito può tornare in preparazione. Nessun test lo prova, quindi il mutante sopravvive. L'agente scrive il test che mancava: da "spedito" a "in preparazione" deve fallire. Mutante ucciso.
Il requisito però era muto. Magari in magazzino capita davvero di dover riportare indietro un ordine segnato spedito per sbaglio, e nessuno lo ha scritto perché nessuno ci ha pensato mentre scriveva la specifica. Adesso quel divieto è diventato una regola di business: c'è un test che lo difende, con un nome parlante. Chi lo incontra tra sei mesi non sa se qualcuno lo ha deciso o se lo ha solo dedotto un agente.
Un sopravvissuto può essere una domanda
Per questo, invece dell'"auto-fix", meglio chiedere all'agente di smistare i sopravvissuti prima di scrivere qualsiasi test.
Se il requisito è chiaro e il comportamento è già stato deciso, il mutante mostra che la suite non lo difende, e serve un test. È il mutation testing come controllo di qualità: l'implementazione è finita, è corretta secondo chi l'ha letta, e vuoi sapere se la suite la proteggerebbe da una regressione.
Se il requisito è ambiguo o muto, il sopravvissuto ha trovato un punto in cui
l'implementazione ha fatto una scelta che nessuno ha preso: il confine di
free_shipping, la transizione dell'ordine. Qui l'agente non deve scrivere un
test, ma segnalare il punto a chi ha scritto il requisito. Dove l'implementazione non ha
scelto niente, perché al caso non ha pensato nessuno, non c'è codice da mutare e il
mutation testing non vede niente.
Smistare è più difficile che scrivere il test: chiede all'agente di distinguere un comportamento che manca da un comportamento voluto, e quella distinzione sta nel requisito. Se l'agente vede il codice e i documenti, il requisito ce l'ha. Il difficile è capire se il documento tace davvero o copre il caso senza nominarlo.
Ci si ferma quando ogni sopravvissuto ha una risposta
Uno score da raggiungere è facile da controllare, e il 95% di prima mostra quanto sia facile arrivarci nel modo sbagliato. Con la copertura era successa la stessa cosa. Lo smistamento dice di ogni sopravvissuto cosa farne; in cambio, qualcuno deve leggerlo.
E l'agente deve poter concludere: restano quattro mutanti, due sono equivalenti (la modifica non cambia nessun comportamento osservabile, quindi nessun test può ucciderli), due sono domande per chi ha scritto il requisito, non servono altri test, ecco perché. Un agente che può solo salire verso il 100% non ha modo di dire che ha finito.
C'è anche un motivo pratico per non uccidere tutto. Con un agente i test costano poco e se ne accumulano centinaia, ma ogni test aggiunto resta: va mantenuto quando il codice cambia e capito da chi arriva dopo. Il tempo che l'agente impiega a scriverlo è la parte più piccola del costo. E le mutazioni sono lente, quindi conviene lanciarle solo nelle aree critiche, dove un errore costa.